AI 对话助手 vs. AI 员工:真正的分水岭是“执行与验证”
多数 AI 工具只会生成看似合理的代码,然后把调试重任踢回给你。本文深入剖析为什么真正的 AI 员工与对话助手的本质区别在于沙箱执行环境与可验证的交付闭环。
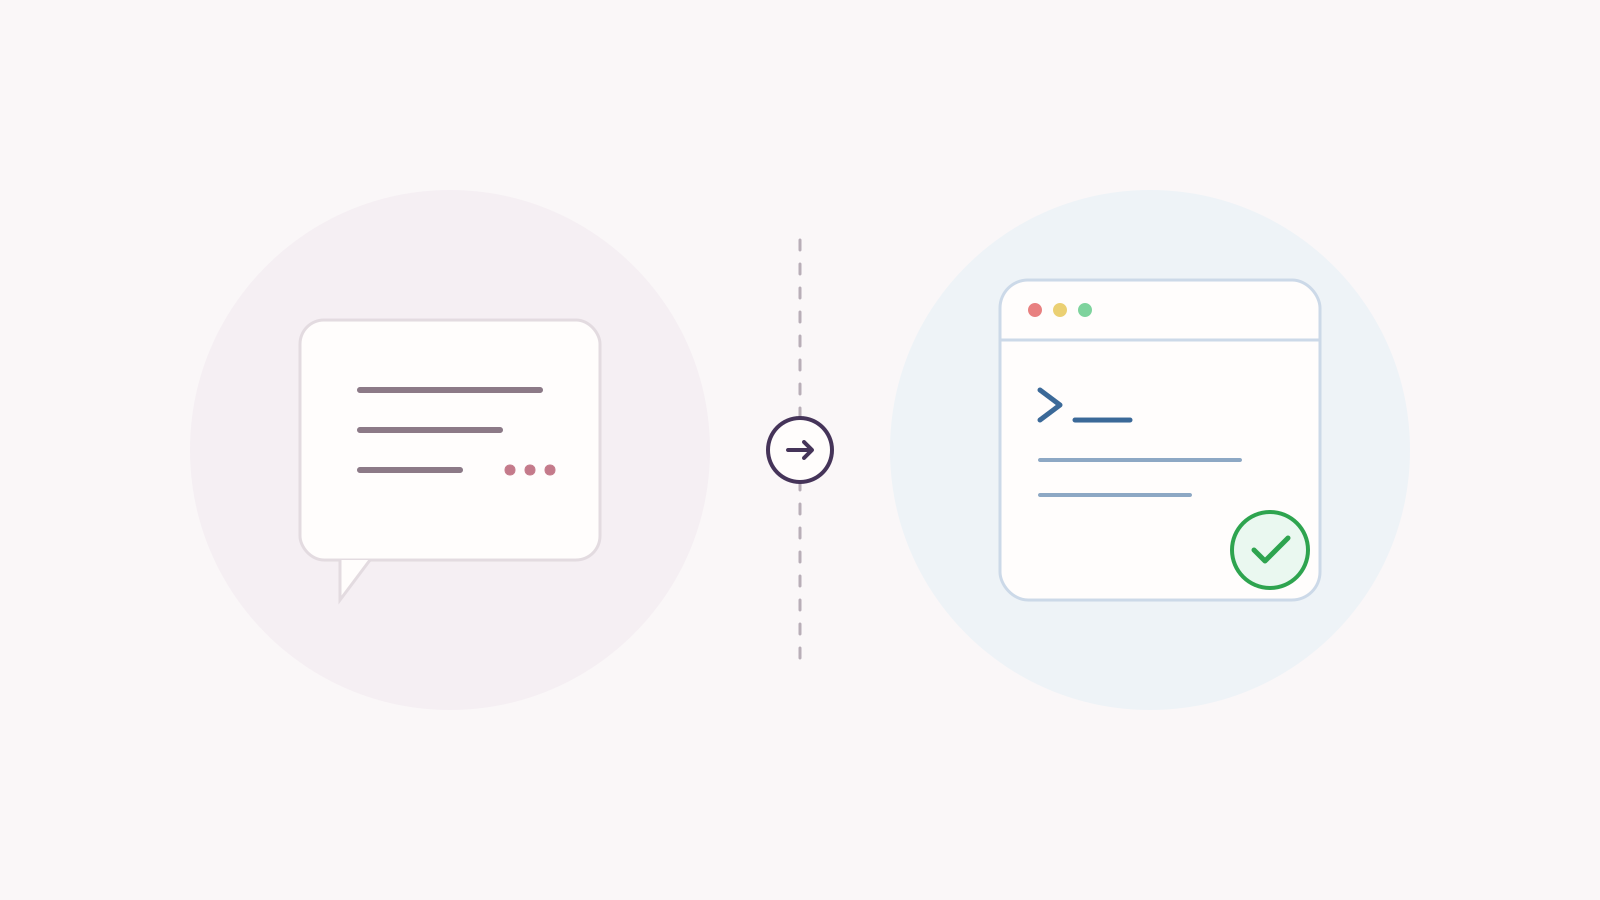
概念插图:传统对话机器人停留在文本生成,而具备执行能力的 AI 员工在安全沙箱中运行、检验并验证工作产物。
用过 AI 的团队,几乎都经历过下面这个让人哭笑不得的场景:
你在对话框里输入:“帮我拉一下上周 Google 搜索里哪些页面的自然流量下滑了。”
大模型反应神速,一秒钟吐出 50 行极其工整的 Python 脚本,类型注解、文档注释一应俱全。最后,它贴心地附上一句:
“你可以把这段代码复制到本地终端运行试试。记得先装好依赖,如果遇到任何报错随时发给我!”
活其实一点都没少干。它只是把球又踢回了你脚下。
整个任务里最省力的环节——“打字敲代码”——它替你做完了;但真正耗费心力的核心环节——配虚拟环境、管 API 密钥、排查 ModuleNotFoundError、处理接口限流重试、检查导出的数据文件有没有损坏——依然 100% 得由你亲手解决。
如果一个 AI 助手每走一步都需要人类在旁边手动复制、粘贴、运行和排错,那它根本不是员工,充其量是一本会说话的互动式技术手册。
两道真正的分水岭
要想明白为什么那么多团队引入 AI 后效率没有实质变化,我们得跳过 Prompt 本身,直接看底层的系统架构。
对话助手与 AI 员工执行闭环对比
flowchart TB
  accTitle: 对话助手与 AI 员工执行闭环对比
  accDescr: 对比单纯的文本生成流程与具备执行、验证和交付物的自治员工闭环。
  subgraph Chatbot["传统对话助手链路"]
    P1("用户输入需求") --> LLM1("模型生成推理")
    LLM1 --> T1("文本回答 / 代码草稿")
    T1 -.-> H1("人工手动复制、运行与排错"):::channel
  end
  subgraph Employee["AI 员工执行闭环"]
    P2("用户输入需求") --> Plan("拆解执行计划")
    Plan --> Box("沙箱运行环境
内置终端、Python 与工具"):::resource
    Box --> V{"验证产物与状态
Exit Code 是否为 0?"}:::gateway
    V -- 报错 / 非零退出码 --> Box
    V -- 校验成功 --> Art("交付最终制品
已验证的文档 / 数据报告"):::agent
end1. 临时会话气泡 vs. 持久运行时环境
传统的对话机器人生活在一个无状态的网页标签页里。它没有硬盘,没有激活的终端会话,完全看不见你的实际文件系统。它的全部能力来自统计学上的 Token 预测。当它建议你运行某条配置命令时,它根本不知道你的电脑上到底装没装对应工具。
而一个真正能分担业务的 AI 员工,必须具备真实的执行运行时(Runtime):
- 持久的沙箱环境:一个与宿主网络隔离的安全容器,可以在其中读写文件、打补丁、编译运行,不用担心搞崩宿主系统。
- 直接使用工具与终端:能够自主执行命令行指令、启动后台守护进程、读取日志,不需要人肉搬运。
- 跨轮次的状态保留:当前目录、环境变量和安装的依赖库在对话中是持久的。第 1 步建好的虚拟环境,第 2 步可以接着用。
2. 验证鸿沟:停在字数凑齐,还是停在结果交付?
大语言模型的基本训练机制是:当生成的文本在概率上看起来完整时,输出 [EOS](End-of-Sentence,句子结束)标记。但在实际业务中,这会导致一个极度危险的陷阱:“看起来做完了”的错觉。
模型可以写出一份逻辑严密的财务清洗脚本,并且在回答里言之凿凿地解释分析结果。但只要底层数据表里多了一个空值(None),代码在第 4 行就会彻底报错崩溃。
真正的员工遵守的是工程交付规范,而不是聊天规范:
- 基于真实证据交付:任务不是因为“语言通顺”而完成,而是因为目标文件确实落到了磁盘上、通过了语法和格式校验、数据完全对得上。
- 静默自愈与容错:当接口偶发
502或脚本报出网络超时,合格的自治伙伴不会把原始报错堆栈直接砸到用户脸上,而是在沙箱里检查 stderr、调整退避重试逻辑,然后重新跑通。 - 强制试运行原则(Dry-Run):在挂载周期性定时任务(比如每天早报或报警监控)之前,必须先在当前会话里完整干跑一次。试运行没出正确结果,绝不上线。
技术特性对比矩阵
| 能力维度 | 传统对话助手 / 聊天工具 | 规则型自动化(Zapier / n8n) | 可执行 AI 员工(如 Leina) |
|---|---|---|---|
| 主要交付物 | 原始文本、代码片段、建议 | 被动触发的 Webhook 事件 | 已验证的最终产物(PDF、报告、PR、文件补丁) |
| 执行环境 | 无(无状态浏览器会话) | 云端固定的静态节点 | 持久隔离的沙箱环境,含终端与 Python |
| 错误自愈能力 | 要求用户把报错信息复制回聊天框 | 直接报错中断或跳过 | 自行捕获 stderr 与非零退出码并原地修复 |
| 接口格式微调适应 | 具备强推理能力,但无动手环境 | 接口字段一旦变化,流程立刻瘫痪 | 自动识别报错、动态调整解析器,继续推进 |
| 团队凭证管理 | 用户在 Prompt 中明文粘贴密钥 | 全局 OAuth 授权,权限难以细分 | 团队托管的受限连接,成员无需接触原始密钥 |
| 自动化稳定性 | 无法自主执行定时任务 | 刚性的轮询机制 | 经由本地试运行验证的周期任务 |
真实场景实测:周一早上的搜索与增长巡检
来看一个增长与运营团队每个周一都要面对的常规任务:“拉取过去 7 天 Google Search Console 的数据,找出自然搜索点击下滑的页面,并在团队群里发一份核心摘要。”
对话助手的处理方式:
- 你提出需求。
- 助手生成了一段 40 行调用 Google API 的 Python 脚本。
- 你打开本地终端配环境、下载 Google 凭证 JSON 文件、尝试运行代码。
- 运行崩溃:API 返回的日期格式跟脚本里的正则解析不一致。
- 你把堆栈报错复制回助手,拿到修改版,再试一次。
- 你拿到导出的原始 CSV,自己导入表格软件整理,最后手动编辑文字发到团队群。
可执行 AI 员工的处理方式:
- 你直接在团队协作平台(Slack、Discord 或飞书)里指派任务。
- AI 调用团队预先配置好的只读授权连接(详见 安全应用连接)。
- 它在本地隔离沙箱中编写查询逻辑、执行抓取并校验 HTTP 响应。
- 如果接口返回了预期之外的空值,AI 在沙箱中捕获异常,自行动态修正解析规则并重新运行。
- 它把洗好的数据排版成整洁的简报或校验过的 PDF 附件,确认内容完整无误后,直接推送到讨论群组。
两者的差距根本不在大模型的智商,而在于到底是谁在扛下执行的脏活累活。
企业级落地的防线:凭证隔离与安全边界
技术负责人迟迟不敢给 AI 开放执行权限,核心顾虑通常只有一个:“AI 如果能跑代码、碰终端,会不会误删数据或搞出事故?”
这也正是为什么企业级 AI 员工绝不能依赖在聊天框里粘贴明文密钥。成熟的架构必须具备三道工程防线:
- 容器级沙箱隔离:AI 的执行环境与生产集群物理隔离。临时文件的改动、依赖安装和脚本试跑都在一次性容器中完成,触碰不到宿主网络。
- 团队受限连接体系(Scoped Connections):密钥由团队统一管理,绝不暴露给对话上下文。成员根据权限调用只读或指定范围的连接,AI 只能在限定边界内操作。
- 不可逆操作拦截卡点:任何产生不可逆副作用的行为(如公开发布、修改线上规则、删除生产资源),必须强制经过人类二次确认,绝不擅自越权。
评估下一款 AI 员工的 3 个试金石
下次看到形形色色的 AI 员工宣传片时,不妨用下面这三个朴素的工程问题去检验它:
- 它是自己在受控环境里跑通代码,还是把代码复制回给你?
如果它还是让你去跑终端,你买的就不是员工,而是一份说明书。 - 它在通知你任务完成前,有没有真正校验过产物?
询问它如果外部 API 报错或者生成的文件损坏时会怎么处理。如果它连退出码(Exit Code)的概念都没有,上线后一定错漏百出。 - 它在上线自动化任务前,是否强制要求试运行?
合格的数字员工绝不盲目配置无人值守的任务,只有在你眼前成功试跑过并经你确认的结果,才允许挂载定时执行。
常见问题解答(FAQ)
AI Agent 和 AI 员工有什么核心区别?
“AI Agent”是一个技术层面的统称,泛指一切能通过工具调用采取行动的 LLM 系统;而“AI 员工”则代表着企业级工程交付标准:持久记忆、沙箱隔离环境、团队级凭证安全管控,以及自主闭环验证交付物完整性的能力。
让 AI 运行命令行指令安全吗?
安全的前提是运行在隔离的沙箱容器中。成熟的系统会把执行环境与宿主机器和生产核心网络隔离开,同时对外部业务系统采用严格的最小权限授权(Least Privilege),杜绝越权访问。
为什么像 Zapier、n8n 这类规则工具在处理复杂工作流时仍显吃力?
规则型自动化工具依赖严格预定义的结构化输入。只要上游接口数据稍有改动、网页结构调整或出现异常数据类型,整条链路就会直接挂掉。具备沙箱环境的 AI 员工则可以读取异常报错,动态调整清洗逻辑,自愈并完成最终交付。